echo $0echo $u war glaub ich userecho $7 ist der return wert vom letzten programmz.B. Nützlich bei testtest 2 -lt 6echo $7 <--- gibt zurück ob 3 kleiner als 7 ist (in diesem Fall 0)
Scope
Variablen sind in der Regel global
Lokale Variablen sind nur innerhalb von Subroutinen erlaubt und müssen mit dem Schlüsselwort local gekennzeichnet werden
Argumentübergabe
Parameter können über die Kommandozeile an das Bash-Skript übergeben werden
Im Skript können diese mit $1, $2, … abgerufen werden
Die Anzahl der Argumente ist in $# gespeichert
Alle Argumente nacheinander können mit $@ ausgegeben werden
Mit read können Strings in Variablen gelesen werden
Die variable $REPLY speichert die Antwort standardmäßig
Mit -a können die Werte in ein Array gelesen werden
Beispiele
read word1 word2echo "Here is your input: \"$word1\" \"$word2\""readecho "You said $REPLY"read -a arrayecho "The words are ${array[0]} and ${array[1]}"
# Einlesen in die Umgebungsvariablereadecho "You said " $REPLY# Einlesen in angegebene Variablenread word1 word2echo "Here is your input: \"$word1\" \"$word2\""# Einlesen in ein Arrayread -a colorsecho "The first two colors were: ${colors[0]} and ${colors[1]}"
Mit Backticks ` lassen sich Ausgaben zu Eingaben anderer Kommandos machen
#!/bin/bash# Die backticks führen zur Auswertung# des uname Kommodos (Ausgabe: GNU/Linux)echo `uname -o`# Ohne backticks erhalten wir nur ein# Echo, d.h. die Ausgabe ist: uname -oecho uname -o
targets - Ein oder mehrere target-Bezeichner, durch Leerzeichen getrennt
Make wird immer nur die commands ausführen, um targets zu bauen, die out-of-date sind
Die meisten targets gehören zu einem File mit dem gleichen Namen, d.h. das bauen des targets erzeugt dieses
Eine Ausnahme sind phony-targets, die kein File erzeugen
Um ein target ausdrücklich als phony-target zu vereinbaren, wird es zum prerequisite des speziellen targets.PHONY erklärt
Beim Aufruf eines phony-target werden immer die zugehörigen commands ausgeführt
prerequisites - Files, die nötig sind um das target zu bauen
Make checkt ob ein bereits gebautes file wiederverwendet werden kann
Ist ein gebautes file neuer als target, muss neu gebaut werden
commands - Abfolge der einzelnen Aktionen, die nötig sind, um das target aus den prerequisites zu bauen (=recipe)
Kommentare - Das #-Zeichen markiert den Rest der Zeile als Kommentar
Variablen - Können per Zuweisung vereinbart werden
Einige Variablen sind vordefiniert:
CXX - C++ compiler command
CXXFLAGS - C++ compiler options
LDFLAGS - Linker options
Um eine Variable aufzulösen wird das $-Zeichen , gefolgt vom Variablenbezeichner in runden Klammern verwendet
Weitere Symbole können innerhalb von rules verwendet werden:
$@ - target
$< - Name of first prerequisite
$^ - Names of all of prerequisites separated by spaces
Makefile per configure-Skript automatisch generieren
Problem: Ablageorte, Dateibezeichner, Versionsnummern und verwendete Werkzeuge unterscheiden sich auf den Plattformen. Ein Makefile mit festgelegten Optionen ist nicht portabel
Lösung: Das Makefile wird von einem configure-Skript aus dem Template Makefile.in erzeugt.
Das automake Programm generiert das Template Makefile.in aus der Datei makefile.am
Auch das configure-Skript wird automatisch konfiguriert
Im configure.ac kann man einstellen, wie übersetzt werden soll
Im Makefile.am werden nur die Optionen vereinbart, die plattformübergreifend gültig sind
Die Programme eines digitalen Rechensystems, die zusammen mit den Eigenschaften der Rechenanlage die Grundlage der möglichen Betriebsarten des digitalen Rechensystems bilden und insbesondere die Ausführung von Programmen steuern und überwachen.
Steuert und verwaltet Computer-Ressourcen, auch Betriebsmittel
Gibt oft die Kontrolle ab und ist auf den Prozessor angewiesen, die Kontrolle zurück zu bekommen
Zuse; Neumann; Apps und OS in einem; Stapel-Verarbeitung mit Lochkarten; OS: EIn/Ausgabe, Umwandlung von Zahlen und Zeichen
60er Jahre
CPUs schneller als E/A-Rate; Echte Parallelität, Multiprogramming, Prozess als virtueller Prozessor; Speicher wird virtualisiert; Mehrnutzerbetrieb durch Timesharing
70er Jahre
Einsatz von C; Prozess wird zur Schutzumgebung mit eigenem Adressraum und Rehten
80er Jahre
Arbeitsrechner (z.B. MS-DOS); Ethernet, vernetzte Systeme -> Komplexe Prozesse; Adressraum und Prozess werden wieder getrennt, lightweight-Prozesse, Threads; GUIs; Parallelität; Betriebssystem über Rechnergrenzen hinaus, verteiltes System
Das Betriebssystem kann die Ausführung laufender Prozesse beim Eintreten einer Ausnahmesituation (en. Exception) abbrechen und die Ursache der Unterbrechung durch ein sogenanntes Signal bekannt machen
Wenn der Prozess nur unterbrochen werden soll, muss ein benutzerdefinierter trap handler installiert werden
System-Exceptions sollten für die Verarbeitung technischer und nicht logischer Fehler verwendet werden
Shared memory ist eine einfache Möglichkeit zur Kommunikation unter Prozessen. Dabei wird ein Speichersegment dem logischen Adressraum mehrerer Prozesse hinzugefügt.
Der gemeinsame Speicher hat keinen internen Mechanismus zur Synchronisation, der Nutzer muss ein eigenes Sperrverfahren, z.B. mit Spin Locks implementieren.
Physikalische Adressen werden von der MMU verarbeitet.
Logische Adressen - auch Virtuelle Adressen, davon können beliebig viele von der CPU gebildet werden. Für logische Adressen wendet die MMU ein dynamisches Mapping an.
Mehrere Relationen sind möglich:
Ein Prozess besitzt genau einen Adressraum
Mehrere Prozesse teilen sich einen Adressraum (Shared Memory)
# Die Argumente der Kommandozeileecho $1 $2 $3# Alle Argumenteecho $@# Lassen sich in ein Array speichernargs=("$@")# Anzahl der übergebenen Argumenteecho $#
Wichtig/Umdenken: Rükgabe von 0, falls es wahr ist (0 - Kein Fehler)
Beispiele
Anwendung:
if $(test $1 -gt $2); then echo $1 is greater than $2# Die eckigen Klammern rufen auch test aufelif [ $1 -lt $2 ]; then # Äquivalent: elif $(test $1 -lt $2); echo $1 is smaller than $2else echo $1 and $2 are equalfi
v=5w=vecho $v # auslesenv="oth"echo $v # othecho $0 # $0 gibt den Namen der shell aus, hier: bashtest 2 -lt 6 # ist 2 kleiner als 6?# Programme ausführen# Angenommen, wir haben ein Programm test im Verzeichnis.test # führt das Programm nicht aus, sondern den test-befehl# So ruft man das Programm auf:./test# Den Return-Wert findet man dann in folgender Umgebungsvariable:echo $? # gibt den return-wert des letzten programms aus
In spitzen Klammern <stdlib.h> dann steht die Bibliothek im Standard-Bibliothekenverzeichnis, aufrufbar mit echo $INCLUDE, wahrscheinlich in /usr/include/
In Anführungszeichen dann sucht der Compiler im aktuellen Verzeichnis
cc -c factorial.c# -c heißt compile, heißt ein object file, ein binary kommt raus aber kein executable.# Da steht kein main drin, das kann für den Linker verwendet werden# Einbinden anderer o-filescc test.c factorial.o square.o -o testStuff# Macht eine library aus den o-filesar r libstuff.a factorial.o square.o# Dann noch indizieren um es als Bibliothek verwenden zu könnenranlib libstuff.a
In C erlauben ...-Parameter die Übergabe beliebiger Daten. Die interne Verarbeitung funktioniert mit va_start, va_arg und va_list aus stdarg.h.
Regel: mind. ein Parameter muss bekannt sein
Beispiele
Beispiel 1
#include <stdarg.h>int add(int zahlen, ...) { va_list zeiger; int zahl; va_start(zeiger, zahlen); do { zahl = va_arg(zeiger,int); zahlen += zahl; } while(zahl != 0); va_end(zeiger); return zahlen;}
Aufruf z.B. mit:
printf("%d\n",add(11,12,13,0));
Beispiel 2
#include <stdio.h>#include <stdarg.h>void printNumbers(int count, ...) { va_list args; // Deklarieren Sie eine Variable vom Typ va_list. va_start(args, count); // Initialisieren Sie die Variable mit va_start. for (int i = 0; i < count; i++) { int num = va_arg(args, int); // Holen Sie den nächsten Parameter aus der Liste. printf("%d ", num); } va_end(args); // Beenden Sie die Verwendung der va_list. printf("\n");}int main() { printNumbers(3, 1, 2, 3); // Beispielaufruf mit drei Parametern. return 0;}
if $(test $1 -gt $2); then echo $1 is greater than $2elif [ $1 -lt $2 ]; then # Kurzschreibweise echo $1 is smaller than $2else # elif [ $1 -eq $2 ]; then echo $1 and $2 are equalfi
Moderne Betriebssysteme stellen Anwendungen Ressourcen durch untersützende Dienste (Dämonen, eng. Daemons) zur Verfügung.
graph TB
A[Anwendung] -->|leicht, einfach| B["Dienste:
Umgang mit den Ressourcen
(Betriebsmittelabstraktion)"]
B -->|schwierig, umständlich| C1[Betriebsmittel]
Beispiele
initd - Elternprozess aller anderen Prozesse (PID 1)
fork dupliziert den Prozess und gibt die Prozess-ID zurück
Der duplizierte Prozess hat immer die ID 0
Unterhalb dieser Zeile macht nur noch der Kindprozess weiter
Weil der Elternprozess sich danach sofort beendet hat, wird der Kindprozess vom initd “adoptiert”
Das SIGHUP-Signal kommt nicht durch und dadurch bleibt der Prozess auch am laufen, wenn sich der Elternprozess schließt
Daemon unsterblich machen
Bei vielen Daemons ist es erwünscht, dass sie niemals nicht laufen und immer wenn sie beendet werden wieder neu starten
for (;;) { // Bis zum nächsten Stromausfall procid = fork(); if (procid > 0) { // Elternprozess: // Wartet auf Terminierung wait(&zustand); // Neuer Kindprozess übernimmt } else { // Kindprozess läuft for (;;) { // Hier kommen wir nur per SIGKILL raus // Um den Daemon zu beenden, muss der // Elternprozess beendet werden } }}
Der Prozess dupliziert sich
Der Elternprozess wartet bis das Kind beendet wurde
Sobald das passiert ist, wird die Schleife wiederholt und ein neues Kind wird erstellt
fork - Klont das Aktuelle Programm in einen Kindprozess, welcher ab dann selbstständig weiterläuft
Beschreibung
fork(): int
Mit fork() lässt sich ein Kindprozess erzeugen, der per Kopie aus dem Elternprozess generiert wird, d.h. Variableninhalte sind zunächst gleich, Änderungen aber nur lokal wirksam -> exec dient zur Ausführung eines neuen Programms durch den Kindprozess.
Rückgabewerte
fork() gibt die Prozess-ID (meist ein int) des erstellten Prozesses zurück.
Beispiel
childPID = fork( );if (childPID > 0) { /* Der Elternprozess ist hier aktiv */} else if (childPID == 0) { /* Der Kindprozess ist hier aktiv */} else { /* Ein Fehler ist aufgetreten: errno auswerten .. */}
Mit fork lässt sich ein Kindprozess erzeugen, der per Kopie aus dem Elternprozess generiert wird, d. h. Variableninhalte sind zunächst gleich, Änderungen aber nur lokal wirksam -> exec dient zur Ausführung eines neuen Programms durch den Kindprozess
Mit wait kann der Elternprozess auf die Terminierung eines beliebigen Kindprozesses warten
Nach dem der Kindprozess (z. B. per exit) terminiert, ist die nebenläufige Aktivität beendet
Jeder Prozess hat unter anderem einen privaten Stack, Heap, Code und Daten.
Das Betriebssystem sichert (nebenläufigen) Prozessen Konsistenz bzgl. ihrer internen Zustände und der aller genutzten Betriebsmittel (Register, PCB) zu.
Registerinhalte müssen beim Hin- und Herschalten (Kontextwechsel) zwischen Prozessen zwischengespeichert werden.
Der Prozesskontrollblock (kurz PCB) enthält u.a. den Programmzähler, Registerinhalte, Scheduling-Informationen, Memory-Management Informationen, Account-Daten und den Zustand eines Prozesses.
Im allgemeinen Fall hat man mehr Prozesse als Prozessoren, was zu einem Wettbewerb zwischen Prozessen führt
Damit alle Prozesse auf einem Prozessor vorankommen, schaltet der Prozessor zwischen den Prozessen um, siehe Context Switch
Zur Vereinfachung wird das Umschalten “versteckt”: jeder Prozess erhält einen virtuellen Prozessor
Diese idalisierte Sicht erlaubt es, von einem Starten, Anhalten, Warten oder Beenden eines Prozesses zu sprechen, obwohl der ausführende Prozessor tatsächlich weder wartet noch anhält
Die Auswahl, auf welchen Prozess als nächstes umgeschalten wird, geschieht erst zum Zeitpunkt des Umschaltens, also dynamisch. Folgende Kriterien sind möglich:
In Unix wird jedem Prozess ein nice-Level zugeordnet, welches aussagt, wie “egoistisch” der Prozess in Hinsicht auf Rechenzeit gegenüber anderen ist. Der nice-Level hat einen Wert zwischen -20 und 19.
Die CPU-Nutzung von Prozessen mit Priorität ist proportional zu . Wird nun der nice-Level für einen Prozess mit nice +15 <PID> erhöht, so erhält dieser (im Vergleich zu Prozessen mit normaler Priorität ) die CPU nur der Zeit zugeteilt:
einen Folgeprozess selektieren. Die Übergänge 1. und 4. werden von den Prozessen ausgelöst und sind nicht Präemptiv. Alle anderen, möglichen Zustandsübergänge heißen Präemptiv.
Ein first come, first serve Scheduler startet die Prozesse in der Reihenfolge, in der sie eingetroffen sind. Meist ist die durchschnittliche waiting time lang: Convoy-Effekt.
Beim Round Robin-Scheduling erhält jeder Prozess gleich viel Rechenzeit. Die Rechenzeit ist das sogenannte Time Quantum, nach maximal dieser Zeit wird ein neuer Prozess gewählt. Das Time Quantum ist entscheidend für die Scheduling Kriterien.
Eine Pipeline ist ein Taskparalleles Programmiermodell, bei dem eine große Menge unabhängiger Eingabedaten durch eine Abfolge von stages verarbeitet wird.
Die Warteschlange wird im FIFO-Prinzip abgearbeitet
Zur Identifikation und zum Vergleich von Threads stehen die Funktionen pthread_self und pthread_equal zur Verfügung
Beispiel
#include <pthread.h>#include <stdio.h>#include <stdlib.h>int arrived = 0;pthread_mutex_t taxi;pthread_cond_t station;void *taxiDriver(void *p) { int i; for (i = 0; i < 3; ++i) { // Sperrt das Taxi, damit während dem kritischen Zustand // (Taxi fahren) niemand was anderes mit dem Taxi macht pthread_mutex_lock(&taxi); printf("Mein Taxi fährt\n"); sleep(1); // Kritisch! Nach jedem Ausdruck kann der Scheduler // den Thread unterbrechen. Wenn taxiGuest genau zwischen // der Abfrage `i > 1` und dem schreiben von `arrived` // den Inhalt von `arrived` ausliest, kommt es vor, dass // er denkt er wäre nicht angekommen obwohl die Bedingung // wahr war. Deswegen Taxi sperren! if (i > 1) arrived = 1; pthread_cond_signal(&station); // Nach dem sperren nicht vergessen dass man die Ressource // auch wieder freigeben muss pthread_mutex_unlock(&taxi); }}void *taxiGuest(void *p) { printf("Der Fahrgast entspannt sich...\n"); sleep(1); pthread_mutex_lock(&taxi); while (arrived == 0) pthread_cond_wait(&station, &taxi); printf("Der Fahrgast öffnet die Tür\n"); sleep(1); printf("Der Fahrgast steigt aus\n"); pthread_mutex_unlock(&taxi);}int main(int argc, char **argv) { pthread_t driver, guest; pthread_mutex_init(&taxi, NULL); pthread_cond_init(&station, NULL); pthread_create(&driver, NULL, taxiDriver, NULL); pthread_create(&guest, NULL, taxiGuest, NULL); pthread_join(guest, NULL); pthread_join(driver, NULL); pthread_mutex_destroy(&taxi); pthread_cond_destroy(&station); return 0;}
Ein Remote Procedure Call (RPC) ist eine Technik, die Funktionen auf anderen Computern völlig transparent ausführt.
Ablauf
Der Stub hat die Funktionssignatur wie die eigentliche Funktion. Er vereint die Parameter zu einer Nachricht und überführt sie in eine flache, Pointer-freie Räpresentation (Marshalling)
Der Skeleton (auch Server-Stub) empfängt die Nachricht, zerlegt sie und konvertiert die Parameter in einer auf der Server-Seite lesbare Darstellung
Unter Umständen beinhaltet das Änderungen an der Byte-Folge und Wortlänge
Die benutzerdefinierte Serverfunktion wird aufgerufen und das Ergebnis zurückgeschickt
Der Client empfängt das Ergebnis und und verarbeitet es nach dem Unmarshalling weiter
Ein Deadlock (deutsch Verklemmung) ist die dauerhafte Blockierung von (mindestens 2) Prozessen, die die gemeinsame Ressource nutzen.
Ein Deadlock tritt auf, wenn mindestens zwei Prozesse sich in einem wechselseitigen Wartezustand befinden und dieser Zustand auch durch die Freigabe aller Ressourcen anderer Prozesse nicht aufgegeben werden kann. Einen Deadlock mit nur 2 beteiligten Prozessen nennt man auch Deadly Embrace (tödliche Umarmung).
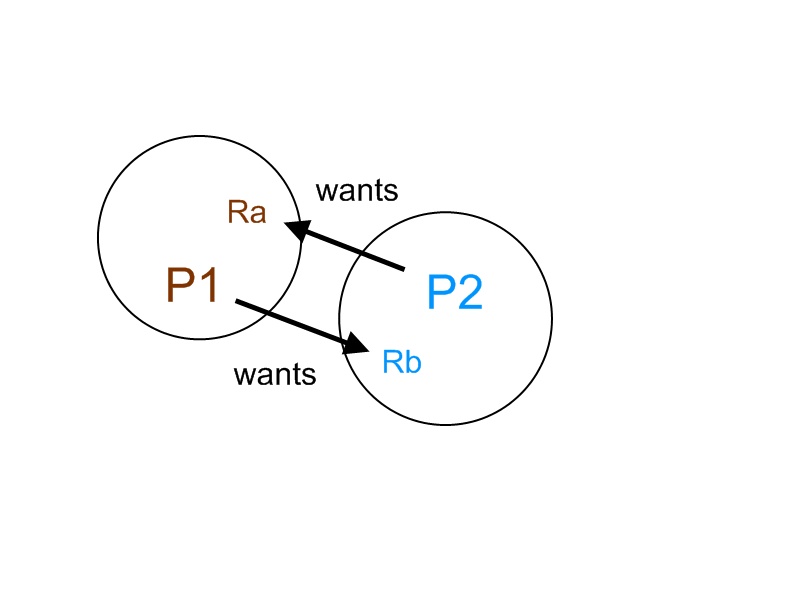
Folgende vier Bedingungen sind notwendig und hinreichend für Deadlocks (Coffman, Elphick & Shoshani, 1971). Das heißt, treffen alle Bedingungen zu, kommt es zwangsläufig zum Deadlock. Trifft mindestens eine Bedingung nicht zu, wird der Deadlock vermieden.
Serielle Benutzung von Ressourcen (mutual exclusion), z.B. synchronized-Methoden in Java
Inkrementelles Ressourcen-Erlangen - Während des Wartens auf eine Ressource gibt ein Prozess bereits erlangte Ressourcen nicht frei
Keine Preemption - Einem Prozess kann eine bereits erlangte Ressource nicht genommen werden
Wartezyklus - Eine Prozesskette existiert, innerhalb der jeder Prozess die Ressource hält, auf die sein Vorgänger wartet
Vermeidung
Detection & Recovery - Terminieren einzelner Prozesse in der Abhängigkeitskette durch Präemptiv
Vorbeugen - Programme so designen, dass es nicht zum Deadlock kommen kann
Eine Sequenz von Prozessen ist sicher im Bezug auf Deadlocks, wenn für jeden Prozess gilt: Die von angeforderten Ressourcen können aus dem Pool freier Ressourcen sofort zugewiesen werden oder sie sind unter den von (mit ) gehaltenen Ressourcen verfügbar.
Einfach gesagt
Eine Sequenz von Prozessen ist deadlock-sicher, wenn jeder Prozess entweder die benötigten Ressourcen direkt aus den noch freien Ressourcen bekommen kann oder diese Ressourcen von vorherigen Prozessen in der Sequenz freigegeben werden. Es gibt also immer einen Weg, alle Prozesse nacheinander ohne Blockierung ablaufen zu lassen.
Ein Resource Allocation Graph (kurz RAG) ist ein Gerichteter Graph, der die Beziehungen von Prozessen und Ressourcen in Verbindung stellt. Er hilft beim Finden von Deadlocks.
Die Knoten können in 2 Teilmengen unterteilt werden:
, die Menge aller Prozesse eines Systems
, die Menge aller Ressourcen eines Systems
Zusätzlich definieren wir:
Anforderungskante - gerichtete Kante wenn ein Prozess die Ressource haben möchte
Zuweisungskante - gerichtete Kante wenn ein Prozess Zugriff auf die Ressource hat
Beispiele
fordert Instanz von an:
hat eine Instanz von :
Grundlegende Fakten
Es gilt:
Wenn der Graph keinen Zyklus hat, kann es nicht zu einem Deadlock kommen.
Wenn der Graph einen Zyklus enthält, kommt es darauf an:
Falls nur eine Instanz je Ressourcen-Typ existiert, kommt es garantiert zu einem Deadlock
Falls mehrere Instanzen je Ressourcen-Typ existieren, besteht die Möglichkeit eines Deadlocks
Um den Bankieralgorithmus anzuwenden, müsen folgende Voraussetzungen erfüllt sein:
Es gibt mehrere Instanzen jedes Ressourcentyps
Die Maximale Anzahl benötigter Instanzen eines Ressourcentyps eines Prozesses muss bekannt sein
Der Prozess muss das System in einem sicheren Zustand belassen, ansonsten muss er warten
Datenstrukturen
: Anzahl der Prozesse, : Anzahl der Ressourcentypen
Available - Vektor der Länge
gibt Anzahl der verfügbaren Instanzen pro Ressourcentyp an
Max - Matrix
definiert den maximalen Bedarf an Ressourcen für jeden Prozess
Allocation - Matrix
definiert die derzeit reservierten Ressourcen für jeden Prozess
Need - Matrix
gibt die noch benötigten Ressourcen für jeden Prozess an
Es gilt:
Beispiel
Gegeben seien folgende Allocation und Max Matrizen, sowie die Available Matrix von den Prozessen bis auf die Ressourcen , und :
Dadurch lässt sich die Need-Matrix berechnen:
Jetzt muss überprüft werden, ob der Need von einem Prozess dem Available-Vektor ist.
Für trifft das nicht zu:
Dementsprechend wird dieser Prozess zunächst übersprungen.
Für trifft das zu:
Dementsprechend fügen wir den Prozess an die Safe-Sequenz an:
Der Available-Vektor wird mit der entsprechenden Zeile aus der Allocation-Matrix erhöht:
Bei trifft die Bedingung wieder nicht zu:
Für trifft die Bedingung wieder zu:
Der Prozess wird an die Safe-Sequenz angehängt:
Der Available-Vektor wird wieder aktualisiert:
So geht das weiter:
Ist man am Ende angekommen aber hat Prozesse übrig, die noch nicht in der Safe Sequenz sind, fängt man wieder von Vorne an:
Daraus folgt die Reihenfolge , die die Sicherheitsbedingungen befriedigt.
Beim dynamischen Laden werden Subroutinen erst in den Speicher geladen, wenn sie aufgerufen werden. Dadurch ergibt sich eine Bessere Speichernutzung: Nicht verwendeter Code wird überhaupt nicht im Speicher platziert. Dies zahlt sich vor allem dann aus, wenn selten genutzte Routinen einen großen Code-Umfang haben.
Beim dynamischen Linken fügt der Linker anstatt von Subroutinen-Code nur einen “Stub” in das Programm ein. Dieser Stub hat (wie beim RPC) nur die Aufgabe, die Subroutine aufzurufen. Das Betriebssystem prüft, ob die Subroutine bereits geladen wurde und lädt sie ggf. nach. Dies ist vor allem dann sinnvoll, wenn ganze Bibliotheken von Subroutines benötigt werden, die dynamisch geladen werden sollen. Solche Bibliotheken nennt man Shared Libraries (.so in Linux, .dll in Windows).
graph TB
A((source<br>program)) --> B
subgraph Compile Time
B[compiler or<br>assembler]
end
C((object<br>module))
D((other<br>object<br>modules))
subgraph Load Time
E[linkage<br>editor]
E --> F((load<br>module))
G((system<br>library)) --> H[loader]
end
B --> C
C --> E
D --> E
F --> H
I((dynamically<br>loaded<br>system<br>library)) -- dynamic linking --> J
H ---> J
subgraph Execution/Run Time
J[in-memory<br>binary<br>memory<br>image]
end
Beim Swapping wird ein inaktiver Prozess vorübergehend vollständig (inkl. PCB) auf einen dazu vorhergesehenen Bereich eines Sekundärspeichers, den sogenannten Backing Store, ausgelagert. Bei der Auslagerung werden zunächst niedrig priorisierte Prozesse übertragen, beim Wiederherstellen werden höher priorisierte Prozesse bevorzugt.
Damit der Scheduler möglichst selten auf den Backing Store zugreifen muss, ist es sinnvoll, Prozesse in der ready queue im Speicher zu halten und nur deren Daten auf den Sekundärspeicher auszulagern.
Positionsunabhängiger Code (mit gcc Option -fpic generierbar) ermöglicht das Zuordnen von Code an Speicheradressen zur Execution Time und damit die größte Flexibilität: Prozesse können im Speicher verschoben werden, einzelne Bestandteile (Unterprogramme) nach Bedarfs hinzuladen und diese untereinander teilen.
Diese Flexibilität hat (gegenüber Compile & Ladezeitoptimierung) Performance-Nachteile und erfordert Hardware-Unterstützung (mehrere Base- und Limit Register).
Physikalische Adressen werden von der MMU verarbeitet.
Logische Adressen - auch Virtuelle Adressen, davon können beliebig viele von der CPU gebildet werden. Für logische Adressen wendet die MMU ein dynamisches Mapping an.
Mehrere Relationen sind möglich:
Ein Prozess besitzt genau einen Adressraum
Mehrere Prozesse teilen sich einen Adressraum (Shared Memory)
Die limit register enthalten die logische, für jeden Prozess spezifische Obergrenze, ab der dessen Adressraum endet (und der Adressraum eines anderen Prozesses beginnen kann).
Die Memory Management Unit (MMU) ist ein Hardware-Gerät, das logische auf physikalische Adressen abbildet. Im MMU Schema wird der Inhalt des Relocation Registers zu jeder Adresse addiert, bevor auf diese zugegriffen wird.
Invertierte Page Tables sind eine Variante des Paging. Dabei gibt es nicht für jeden Prozess eine eigene Liste sondern eine große für alle. In den Einträgen stehen die Nummern der zugehörigen Pages, sowie die PIDs der Prozesse, denen die Seiten gehören. Dies Verringert den Speicherbedarf, allerdings wird der Suchaufwand erhöht, weshalb oft ein Hashed Page Table vorgeschalten wird.
Hashed Page Tables sind eine Variante des Paging mit Hilfe von Hashing. Diese kommen oft bei großen Adressräumen (> 32 Bit) zum Einsatz.
Die virtuelle Seitennummer (logische) wird dabei in eine Page Table gehashed. In dieser Page Table befinden sich i.A. Listen von Elementen für Seiten, die auf die gleiche Position gehashed wurden.
Zum Auflösen einer virtuellen Seitenadresse, muss diese mit allen Elementen der zugehörigen Liste verglichen werden. Sobald ein Treffer für eine Seite gefunden wurde, wird der zugehörige Frame aus dem Speicher geladen.
Dabei wird der physikalische Speicher in Blöcke fixer Größe, sogenannte Frames aufgeteilt. Der logische Speicher wird in gleichgroße Pages aufgeteilt. Jede Page wird auf einen Frame abgebildet.
Framegrößen
Die Größe von Frames ist typischerweise eine Zweierpotenz zwischen und Bytes.
Fragmentierung
Zwar verringert Paging externe Fragmentierung, doch kommt es wegen der fixen Pagegröße zu interner Fragmentierung.
Das Betriebssystem “führt Buch” über alle freien Frames. Meist ist das eine Liste, wo z.B. steht “Zur Page abc gehört Frame 45 xyz”. Dabei hilft ein page table.
Benötigt ein Programm Speicher, so muss das Betriebssystem genug Frames finden.
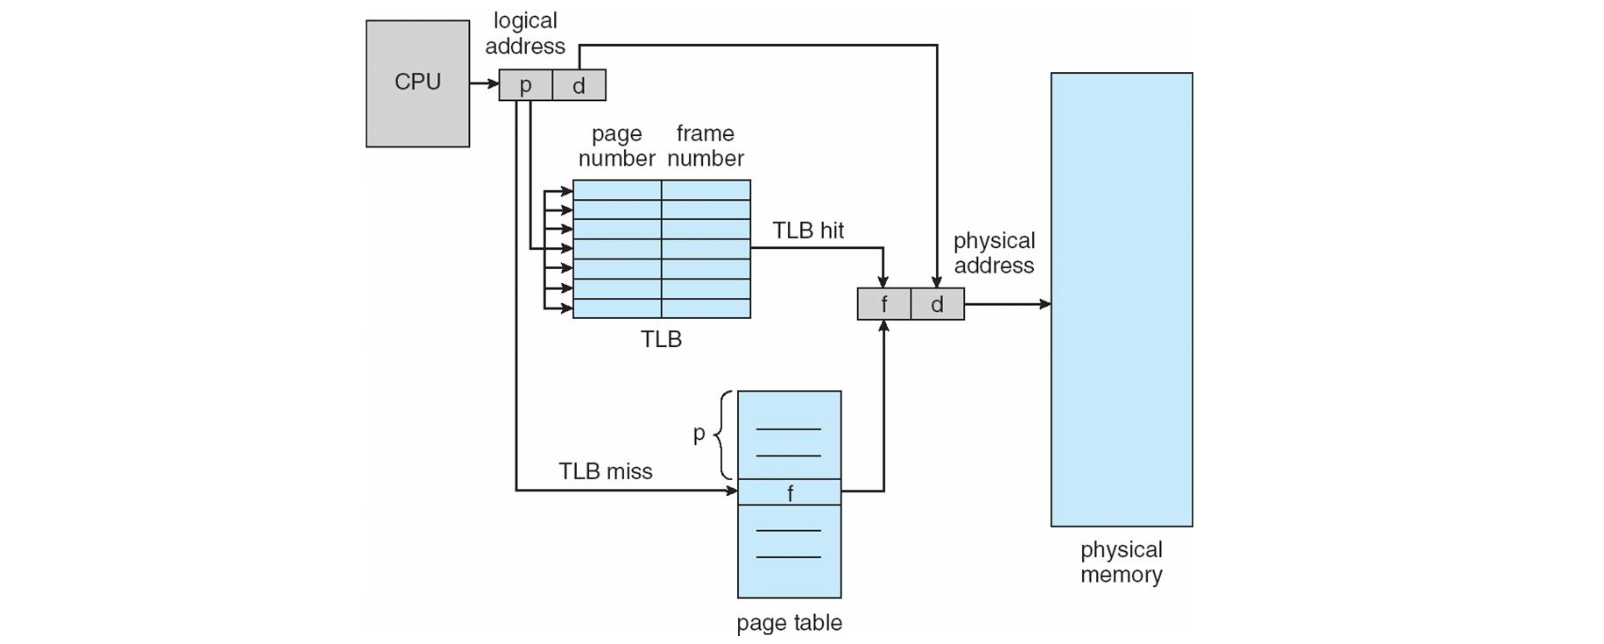
Seitennummer (p) - Dient als Index für die page table und liefert die Basisadresse
Seiten-Offset (d) - Dient zur Auffindung des Speicherinhalts und wird auf die Basisadresse addiert
Prozessspezifischer Zugriffsschutz
An jeden Frame wird ein Flag, das sogenannte valid-invalid Bit angefügt. Diese Bits stehen hinter den Einträgen der Page Tables der Prozesse
valid (v) - Zeigt an, dass eine Seite zum logischen Adressraum des Prozesses gehört, dem der Page Table zugeordnet ist
invalid (i) - Zeigt an, dass eine Seite nicht zum logischen Adressraum gehört und der Prozess, dem die Page Table mit diesem Eintrag zugeordnet ist, folglich nicht auf die Seite zugreifen darf
Segmentierung beschreibt ein Memory-Management Schema, das der User-Sicht auf die Daten entspricht. Ein Programm besteht hier aus einer Ansammlung von Segmenten, wobei jedes Segment einer logischen Einheit entspricht.
Logische Adressen sind hier Zweiertupel: <segment-nummer, offset>
Demand Paging ist eine Variante des Paging, bei der Pages nur in den RAM geladen werden, wenn sie auch benutzt werden. Dadurch ergeben sich einige Vorteile:
Verringerter E/A-Aufwand
Reduzierte Speicherbelegung
Höhere Responsivität
Mehr Benutzer
Für das Demand Paging wird eine zusätzliche Spalte in den Page Tables benötigt: Das Valid-Invalid Bit. Steht es auf v (valid), ist die Page in den Speicher geladen, steht es auf i (invalid), ist die Seite nicht im Speicher und eine trap (der sog. Page Fault) wird verarbeitet. Dafür ist eine zusätzliche Tabelle notwendig, in der steht, ob die Page zum Prozess gehört.
Page gehört nicht zum Prozess
Prozess abbrechen
Seite gehört zum Prozess:
Freien Frame suchen
Seiteninhalt laden - swap
Seitentabelle(n) aktualisieren
Valid-Invalid Bit auf v setzen
Instruktion, die zum Page Fault geführt hat, erneut ausführen
Copy On Write ist eine Methode des Demand Paging, bei der nach einem fork der Eltern- und Kindprozess zunächst die selben Pages verwenden. Erst, wenn einer der Prozesse eine Shared Page modifiziert, wird sie kopiert. Die Prozesserzeugung läuft dadurch schneller.
Page Replacement ist eine Methode des Demand Paging, bei der nicht genutzte Pages, sogenannte victims, aus dem Hauptspeicher ausgelagert werden um Platz für neue Frames, die replacements, zu schaffen.
Verfahren
Die benötigte Page muss auf dem Sekundärspeicher lokalisiert werden
Suche einen freien Frame. Wenn es keinen freien Frame gibt, verwende einen replacement Algorithmus, um einen victim zu selektieren
Der Inhalt des victim-Frames wird gelöscht, die benötigte Page vom Sekundärspeicher eingelesen und diesem Frame zugeordnet, d.h. die Page Tables werden aktualisiert
Der Prozess, der den Zugriff getätigt hat wird neu gestartet
Das FIFO-Verfahren ist ein Verfahren des Page Replacement, bei dem die Pages, die als erstes in den Speicher geladen werden, auch als erstes als victims gekennzeichnet werden.
Der Least Recently Used (LRU) Algorithmus ist eine Methode des Page Replacement, bei der das victim der Prozess ist, der am längsten nicht mehr genutzt wurde.
Es gibt mehrere Möglichkeiten, den LRU zu implementieren:
Logische Uhr
Jede Seite bekommt einen Zeitstempel der den letzten Zugriffszeitpunkt speichert. Wenn eine Seite ersetzt werden soll, wird die mit dem kleinsten Zeitstempel gewählt.
Hitliste
Ein spezieller Stack, auf dem die Seitennummern in einer doppelt verketteten Liste gespeichert sind. Wenn eine Seite referenziert wird, wird sie an der obersten Position des Stacks positioniert. Vorteile:
Der Stack ist viel kleiner als die Page Table, das spart Speicherplatz
Die älteste (bekannte) Seite liegt immer an der untersten Position, der Zeitaufwand der Suche entfällt also
Reference Bit
Jede Seite bekommt ein Bit, das zunächst auf 0 gesetzt wird
Wenn die Seite referenziert wird, ändert sich der Wert zu 1
Wir wissen nicht in welcher Abfolge die Seiten referenziert wurden, aber wir haben ein neues Ersetzungsverfahren: Wir ersetzen Pages Reihum, d.h. eine nach der anderen. Wenn aber die Page das Reference Bit 1 hat:
Setzen wir ihr Reference Bit auf 0
Belassen wir die Page im Speicher
Fahren wir mit der nächsten Page entsprechend fort
Zählverfahren
Für jede Seite gibt es einen Zähler, in dem steht, wie oft die Seite referenziert wurde. Ersetzt wird:
Beim LFU Algorithmus die Seite mit dem kleinsten Zählwert
Beim MFU Algorithmus die Seite mit dem größten Zählwert
Ein Argument für MFU wäre, dass die Seiten mit dem kleinsten Zählwert möglicherweise gerade erst geladen wurden und die Verwendung noch bevorsteht.
Im Demand Paging bedeutet Local Replacement, dass ein Prozess bei einem Page Fault nur Frames aus der eigenen Page Table ersetzen kann, also eigene Frames.
Das Working Set Model ist eine Methode zur Vorbeugung von Thrashing. Es basiert auf der Annahme von Lokalität, also das ein Prozess eine gewisse Menge an Pages zusammen benutzt und sich diese Menge während der Prozessausführung verändert.
Dabei wird ein sogenanntes Working Set Window verwendet. Dieses ist eine Liste aller Ressourcen der letzten Schritte, die der Prozess getätigt hat.
Das Working Set ist dann die Menge aller Ressourcen im Working Set Window zu diesem Zeitpunkt.
Beispiel
Angenommen . Für einen Prozess könnte die Page Reference Table so aussehen:
Eingezeichnet ist bereits ein Zeitpunkt und das Working Set Window. Das Working Set sind dann alle Ressourcen aus diesem Window:
Anpassung von
Das Working Set beinhaltet jetzt also alle Ressourcen auf die der Prozess im im vergangenen Zeitfenster zugegriffen hat.
Ist zu klein, wird es kaum Lokalitäten erfassen.
Ist zu groß, werden oft mehrere Lokalitäten überdeckt.
Ist = LOC, überdeckt das Window das gesamte Programm.
Gegenmaßnahmen
Sei die absolute Anzahl der Seiten die innerhalb des letzten referenziert wurden und
die Anzahl aller referenzierten Ressourcen (total demand frames). Ferner sei die Anzahl der verfügbaren Frames. Dann gilt:
Um Thrashing also zu verhindern, werden Prozesse suspendiert, sobald eintritt. Ist , können Prozesse wieder forthfahren.
Approximierung
Mit Intval Timer und Reference Bits
Beispiel:
Der Timer unterbricht z.B. alle 5000 Zeitschritte
Jeder Eintrag der Page Table bekommt 2 zusätzliche Bits
Bei jeder Timer Unterbrechung werden die Bitinhalte der ersten Spalte in die zweite kopiert und auf 0 gesetzt
Wenn eines der Bits = 1 -> Page im Working Set
Ungenau
Heuristische Anpassung
Ist die Page Fault Rate niedrig, wird die Page Table verkleinert
Ist die Page Fault Rate hoch, wird die Page Table vergrößert
In-Memory Dateien ermöglichen es, E/A-Vorgäge in Dateien durch einfache (und damit schnellere) RAM-Zugriffe zu ersetzen, indem sogenannte RAM Disks Speicherblöcken zugeordnet werden.
Moderne Betriebssysteme führen auch ein implizites Memory-Mapping für Dateien durch: Beim Lesezugriff werden Blöcke in den Speicher geladen, nachfolgende Zugriffe erfolgen (nach Möglichkeit) dort.
Die Systemfunktionen read und write abstrahieren über diese Optimierung.
Das Betriebssystem kann fortlaufend adressierte Blöcke (contiguous memory) auf beliebig viele Seiten (non-contiguous memory) abbilden.
Seitenflattern (auch Thrashing) ist ein Phänomen bei der virtuellen Speicherverwaltung, bei dem ein Prozess aufgrund mangelnden verfügabren Speichers mehr Zeit mit dem Swapping von Pages beschäftigt ist als mit den eigentlichen Berechnungen.
Demand Paging führt zu Beginn eines neuen Prozesses zu vielen Page Faults. Ein Trick moderner Betriebssysteme besteht darin, einige Seiten vorab bereit zu stellen.
Probleme
Wenn die Seiten nicht verwendet werden, werden Einträge der Seitentabelle und - falls Virtueller Speicher verwendet wird - auch Zeit verschwendet. Deshalb stellt sich die Frage, ob die Einsparungen durch die verhinderten Page-Faults größer oder kleiner sind als die Kosten der unnötig vorbereiteten Seiten.
Weil das nachschlagen der Frames hinter Pages oft passiert und langsam ist, werden oft genutzte Pages in einen Assoziativen Cache zwischengespeichert. Dieser Speicher heißt in diesem Zusammenhang auch Translation Look Aside Buffer (TLB). Wird das zugehörige Frame einer Page in diesem Speicher zwischengespeichert, haben wir glück und können schnell den Speicherbereich aufrufen. Falls nicht, haben wir einen TLB miss und müssen wie gewohnt im langsamen Page Table nachschauen.
Schätzung der effektiven Zugriffszeit
Angenommen, wir haben eine Cache-Trefferquote , ein assoziativer Lookup dauert Zeiteinheiten und ein Memory Cycle benötigt eine Mikrosekunde. Dann ist die effektive Zugriffszeit (EAT)
Reichweite des TLB
Die Kapazität des assoziativen Speichers ist durch den TLB begrenzt:
Idealerweise passt das Working Set eines Prozesses in den assoziativen Speicher, andernfalls lassen sich Page Faults folgendermaßen verhindern: